AI五輪メダリストの開成高校生が、AI人材拡大のため、AIと議論した思考記録
2026年4月、ChatGPTが東京大学の入試を解き、合格者の最高点を上回りました。前年には、国際数学オリンピックで金メダル相当の成績も出ています。答えが決まっていて、採点のしかたも決まっている問題は、もうAIの領域です。
では、その領域を極めた人間は、答えのない問題に向かったとき、何をするのか。
2026年7月、オンラインに5人が集まりました。六本木ベンチャーキャピタルが始めた「Agora」というプログラムの、第1回です。Agoraは、突出した若い才能が、AIと深く議論して、まだ世にない新しいものを生み出すプログラムです。
テーマを出したのは、国際人工知能オリンピック(IOAI)2025 銅メダリスト・開成高校3年の山井勇人さんです。「Kaggleを民主化したい」── Kaggle は、世界最大の機械学習コンペティションです。
2時間の議論の末、5人とAIは、Kaggleには無かった出題の形に辿り着きました。まだ世になかった形が1つ、そこで生まれました。
その後、1か月間の開発の末、それは誰でも触れるものになりました。できたプロダクトはこちらになります。

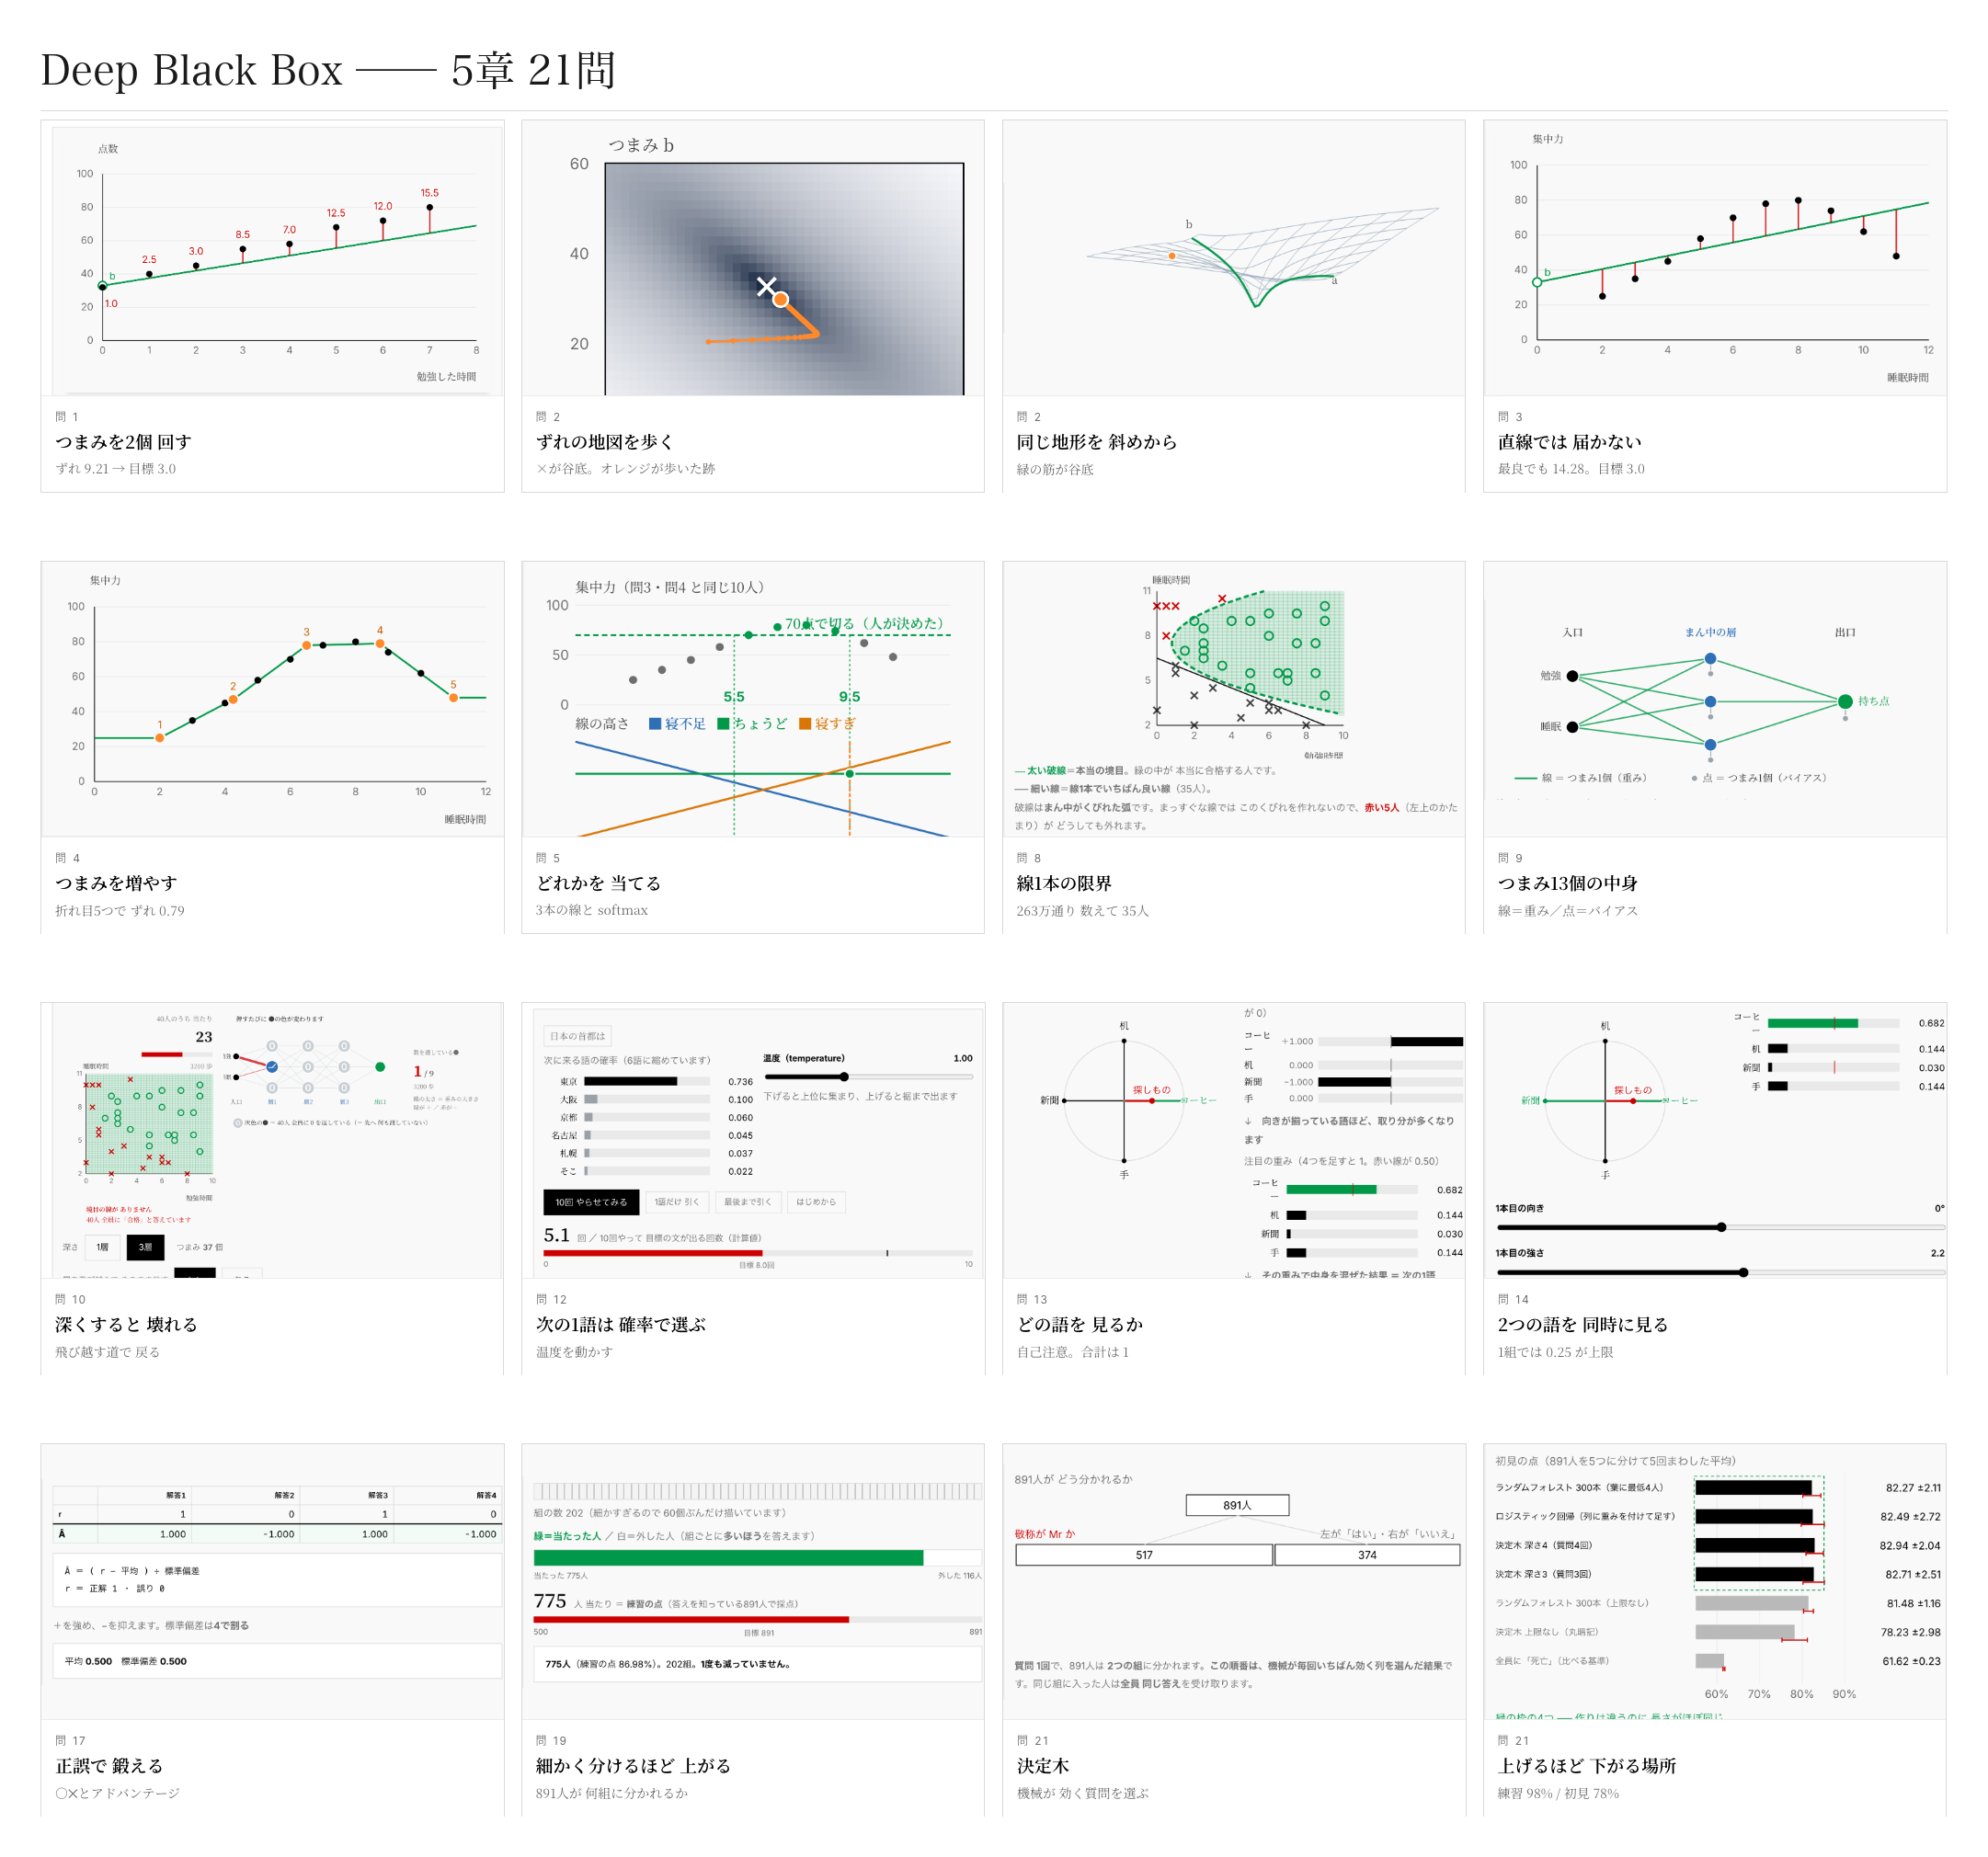
AIのブラックボックスを、1問ずつ開けて手で動かす。全21問。
この日のAgora議論参加者5人
1. なぜ「Kaggleの民主化」をしたいのか
山井さんがKaggleを知ったのは、高校1年の冬でした。偶然です。国際人工知能オリンピックという大会が存在することを知ったのは、日本予選の1か月前でした。そこから1年未満で、彼はメダルを取っています。
つまり、彼の側で足りていなかったのは能力ではありませんでした。知る機会でした。
では、何が入口を塞いでいるのか。本人が挙げたのは、教材の不足ではありませんでした。
同席したもう一人の高校生、聖光学院高校1年で副生徒会長の飯塚さんも、同じ場所でつまずいていました。
2人の感触では、同級生でKaggleを知っている人は1割に届きません。
偶然に左右される状態は、才能の側の問題ではなく、設計の側の問題です。彼が「民主化」と言ったのは、そこに向けてでした。

原理は学校で教えればいいのにな、と彼は話した
当日、参加者全員が一本の記事を見ながら議論していました。日経クロステックの連載「日本、『1億総AI人材』への道」第1回です。IOAI 2025に日本から参加した4人が全員メダルを取ったことを伝えています。山井さんは、その4人の1人です。
記事の見立てはこうです。AIをつくる先端の人材では、日本は海外にひけを取っていない。足りていないのは、その先端を支える裾野 ── AIを使う人の層の厚みである。だから日本が全体として巻き返すには、一般の人材の底上げが要る。
その記事に、原理を学ぶ必要性の話は出てきません。山井さんが引っかかったのは、そこでした。
(LLM=ChatGPTのような、文章を扱うAIのこと。)
彼が増やしたいのは、使う側ではありません。つくる側の裾野です。同席した、京都大学大学院で数学を専攻し、いまは某政府系金融機関にいる北村研一さんが、それを国際比較の話に置き直しました。

北村さんは、原理そのものについても続けています。
では、学校で教えればいいのか
「学校で教えればいい」に対して、その場で別の見方が出ています。
教材があっても、教える人がいても、そこで起きるのは二極化です。足りていないのは知識を配ることではなく、最初に火が点くかどうかでした。三角形の境界を下げるというのは国の規模の話ですが、ここに書くのは、その全体を動かした記録ではありません。入口を1つ増やすために、私たちが何に取り組んだかの記録です。
2. 雑に聞いて、AIの答えを、先に見た
Agoraには前提となる仮説が1つあります。AIは、雑に聞けば雑に答えがちだということです。「いいアイデアを出して」と頼むと、どこかで聞いたような寄せ集めが返ってきやすい。誰が聞いても同じ、無難で平均的な答えになりがちです。誰でも手に入る答えに価値はありません。
だから議論の前に、その「雑に聞いた場合」を全員で見ておきました。使ったAIは Anthropic の Claude Fable 5 です。何の工夫もない指示を1行投げます。
30秒ほどで、5案が返ってきました。
Kaggleの民主化、面白いテーマですね。Kaggleの現状の課題を整理すると、「参入障壁が高い(統計・ML知識、英語、GPU環境)」「上位勢と初心者の断絶」「実務との乖離」あたりがボトルネックです。それぞれを崩すサービスアイデアをいくつかご提案します。
1. 「Kaggle Sherpa」— AIメンター伴走型コンペプラットフォーム ── 初心者がコンペに参加すると、AIエージェントが伴走するサービスです。EDA(探索的データ分析)を一緒に進め、「なぜこの特徴量が効きそうか」を対話で解説。公開Notebookを自動で日本語解説付きに変換。提出前に「このモデルのリークリスク」「CVとLBの乖離原因」を診断。差別化ポイント:答えを出すのではなく「考え方」を教える設計にすることで、単なる代行と一線を画す。
2. 「Micro-Kaggle」— 1時間で完結するマイクロコンペ ── Kaggleのコンペは数ヶ月がかりで、社会人には重すぎます。データセットを小さく、問題をシンプルにした「1時間コンペ」を毎日開催。スマホからでも参加可能(ブラウザ上のNotebook環境を提供)。Duolingoのようなストリーク・リーグ制で習慣化を促進。ビジネスモデル:企業のスポンサードコンペ(採用目的)。
3. 「Kaggle for Domain Experts」— コード不要のコンペ参加 ── 医師、金融アナリスト、製造業エンジニアなど、ドメイン知識はあるがコードが書けない層を取り込みます。自然言語で仮説を記述 →「この検査値と年齢の交互作用が効くはず」→ AIが特徴量エンジニアリングとモデル構築を代行。ドメイン専門家とKagglerのマッチング機能(チーム戦の民主化)。ドメイン知識の貢献度を定量評価し、賞金分配に反映。
4. 「実データKaggle」— 中小企業の課題をコンペ化 ── Kaggleに企業データを出せるのは大企業だけです。中小企業の課題(需要予測、不良品検知など)を、匿名化・合成データ化してコンペとして出題するSaaS。賞金は少額でも「実案件の実績」が参加者の報酬になる。企業側は低コストでPoC、参加者はポートフォリオを獲得できる三方良しの構造。
5. 「Kaggle Replay」— 過去コンペのタイムマシン学習 ── 終了したコンペを「当時のLB状態」から再体験できる学習サービスです。上位解法を段階的にアンロック(自分のスコアを超えないと次のヒントが見えない)。「この時点でGrandmasterは何を考えていたか」を解法write-upと紐付けて追体験。資格・検定と連動させて企業の採用シグナルにする。
私のおすすめ ── 一番事業性が高いと考えるのは 4(実データKaggle)+ 3(ドメイン専門家の取り込み)の組み合わせ です。理由は:「民主化」の対象を参加者側だけでなく出題側にも広げている点が独自/合成データ生成技術(プライバシー保護)が成熟してきた今だからこそ成立する/収益源が明確(企業からのSaaS課金)で、賞金依存のKaggleモデルより持続可能。
特定のアイデアを深掘りしたり、ビジネスモデルキャンバスや技術アーキテクチャに落とし込んだりすることもできますので、お気軽にお申し付けください。
3. 2時間で、人が何を議論したか
対象を絞り込んだ ──「高校生」では広すぎた
最初にやったのは、誰の課題を解決するのかを決めることでした。「高校生」では広すぎる。上場企業を含む60社以上の事業推進や経営に携わり、39件の事業売却実績を持ち、元大手予備校数学講師の糸永季生さんが、教えてきた経験から線を引きます。
そこに北村さんが、それまでの議論を一行に要約しました。
ふわっと広がりかけていた「民主化」が、この一言で最初の輪郭を持ちました。数学出身の人が、定義を確かめる。これが以降ずっと効きます。
AIが全部やってくれるなら、壁はなくなるのか
ここで進行役が、こう問いました。
「提出できる人」と「理解して学べる人」が、ここで初めて分離しました。AIが消すのは前者の壁だけです。
コラム 1 AIに任せてよいのは、どこまでか
「中身を理解しないまま、AIにKaggleをやらせていいのか」という問いは、Agora議論終了後に進行役がAIと相談して整理しました。そこで出た結論は、「やらせてはいけない。ただし全部理解しろというのも間違いで、理解には人に任せていい層と、任せられない層がある」でした。
① 道具の中身 ── 出来合いの道具が内部でやっている計算や数式。AIに任せてよい。専門家も詳しく中身を見ていません。車を運転するのにエンジンの理屈は要らないのと同じです。
② 手続きが正しいかどうか ── データの整え方、答えの漏れ込み、採点のやり方、練習データに合わせすぎていないか。ここが急所です。
③ 結論が正しいかどうか ── 出てきたものを「これで正しい」と受け取ってよいか。ここは任せられません。理由は1つで、正しさの基準を、AIは自分では決められないからです。だから自信のある口調で間違えますし、自分で書いたテストを自分で通して「問題ありませんでした」と報告してくることもあります。分析でも同じで、2つの数字が一緒に動いていれば、それを原因のように語ります。相関関係と因果関係は別ですが、そこを分けるのは人間の仕事です。しかも専門家でも意見が割れます。
② 手続きが正しいかどうか ── これが急所である理由は、難しいからではありません。②を間違えても、結果の見た目にはそれが出ないことがあるからです。しかも、悪いほうに出るとは限りません。
それが実際に起きた記録が1つあります。 Kaggle Competition Master で、Metaの機械学習エンジニアである Andrey Lukyanenko 氏が、2026年7月に公開した記録です。AIエージェントに、Kaggleのコンペを丸ごと走らせています。Agora議論終了後に、進行役が調べました。

① 道具の中身 ── この層は、全部AIがやりました。 課題は、健康診断の記録63万人分から、一人ずつ「要注意」か「問題なし」を見分けるものです。AIは、データの下調べをし、予測の手がかりになる列を自分で約140個作り、3種類のモデルを並行して学習させ、その混ぜ方まで自分で調整して、提出まで自力でやりました。人間は、プログラムをほとんど書いていません。列の中身も、モデルの中で何が計算されているかも、人間は見ていません。それで動きました。
② 手続きが正しいかどうか ── この層で、止まりました。 AIは、自分がうまくできているかを、自分で確かめながら改善を進めます。その確かめ方が、この課題と合っていませんでした。100人に縮めて書きます。
 100人を「要注意」と「問題なし」に振り分ける。
 実際の内わけは、こう偏っている

    要注意   94人  ●●●●●●●●●●●●●●●
    問題なし  6人  ○
 AIが使っていた数え方
    「100人のうち、何人当たったか」

 この課題で求められていた数え方
    「要注意の人を見つけられたか」と
    「問題なしの人を見つけられたか」を、同じ重さで見る
この違いが、AIの判断を片側へ引っぱります。
 判断に迷う一人が出てきたとする。どちらと答えるか

   要注意と答える    → 100人中94人が要注意なので、当たる確率が高い
   問題なしと答える  → 当たる確率は低い
        │
        ▼
   AIが使っていた数え方では、迷ったら要注意と答えるほうが得
        │
        ▼
   その積み重ねで、答えが要注意の側へ寄っていく
        │
        ▼
   問題なしの6人を見つける力は、育たない
AIは、手を抜いたのではありません。渡された数え方に対して、正しく最適化しました。極端まで進めば「全員に要注意」で、その数え方では100人中94人が当たります。一人も見分けていない答えが、いちばん高い数字を出します。そして、機械はここで警告を出しません。数字は上がり続けます。
③ 結論が正しいかどうか ── この層も、外しました。 提出した結果が悪かったとき、AIの診断は「データを増やすのが唯一の道だ」でした。他の参加者がアップロードした非公式のデータを使おうと提案し、これが壁を破る唯一の方法だと、自信を持って主張しました。人間が止めています。
人間が疑ったのは、データではなく、数え方のほうでした。直し方は、最初に自分で決めていたところへ戻すことでした。この課題が求める数え方をそのまま使い、その数え方で自分を確かめる仕組みに組み替える。AIに任せられたのは、①まででした。
AIは東大の数学は解ける。ではKaggleはどうか
議論の途中で、進行役がこう聞いています。
進行役が調べた最新の状況も、その場で共有されました。AIモデルがKaggleでグランドマスターレベルに達したという発表が出ている。それでも東大入試や数学オリンピックに比べると、上限がないぶん、詰めるところが残っている。
東大数学もKaggleも、与えられた問題を、与えられた基準でどこまで詰めるかを競う世界です。山井さんが極めてきたのは、そこでした。この日の2時間が置かれていたのは、その外側です。何を解くかも、何で測るかも、決まっていません。
コラム 2 東大数学と、Kaggleと、実世界の問題は、どこが違うのか
3つ並べると、こうなります。
| 東大数学 | Kaggle | 実世界 | |
|---|---|---|---|
| データ | きれい | 汚い | 汚い |
| 問題 | 与えられる | 与えられる | 自分で決める |
| 採点 | ある | ある | 自分で作る |
| 全体 | 閉じている | 閉じている | 開いている |
Kaggleが実世界に近づいたのは「汚さ」の1点です。実世界でいちばん難しいのは「そもそも何を解くべきか」を決めることで、Kaggleではそれを主催者が全部やってくれています。何を当てるか、何で測るか、データを集めることまで。
そして「閉じている」という1つの性質が、長所と弱点と限界を同時に作っていました。
- 訓練の場として優れている理由 ── やった結果がすぐ返ってくるので、自分の判断が正しかったかが分かる
- AIに追い抜かれる理由 ── 採点表があるので、機械がいちばん得意な形になっている
- 力の証明としての限界 ── 証明できるのは途中の作業の腕前だけ。そしてその途中の作業こそ、AIがいま得意になっている場所
1つめには、東大入試にはない仕掛けがあります。コンペが終わるまで、採点に使う答えの一部が隠されているのです。
期間中ずっと見えている点数に合わせて調整を重ねると、点はどんどん上がります。ところが最後に、隠されていた別のデータで採点し直した点が開きます。そこで順位が大きく落ちる人が出ます。見えている点に合わせるのは、その点を出すデータの癖に合わせているだけで、当てる力が上がったわけではないからです。これを過学習といいます。
つまりKaggleの採点は、答えが合っているかだけを測っていません。「自分の手元の採点を信じたか、それとも目の前に見えている点数に合わせにいったか」──自分の判断が正しかったかどうかの測定です。上の表で「採点がある」のは東大数学も同じですが、隠された採点があるのはKaggleだけです。逆も然りで、証明を厳密に書く力はKaggleでは身につきません。Kaggleでは証明を書かないからです。
進行役の案は数分でダメだと分かった。そこから対象者が見つかった
進行役が案を出します。
数分でダメだと分かりました。ところが、このダメの出方が宝を掘り当てます。彼が続けた一言が、議論の向きを変えました。
「社会の役に立つ」でも「身近な課題を解く」でもない。この人たちの興味は、構造そのものに向かう。
対象者が、部屋の中にいました。ここでターゲットが確定します──数学や構造の面白さに反応する素質があるのに、AIに触れる機会がなかった高校生。
ただしこの日の「民主化」は、裾野を全員に広げることではありませんでした。この層に、入口を1つ届けることです。誰にでも届ける話と、届いていない人に届ける話は、別です。
高校1年生が、テーマを出した本人に、問いを深める質問をした
この日いちばん大事な質問をしたのは、AIでも大人でもありませんでした。
2度目は、もっと踏み込みました。
ここで終わりませんでした。
この解剖の結果として、後に作るものが存在する理由が言葉になりました。読んで終わりにならない場が要る。
セッション後、山井さんはこう言っています。「飯塚さんにちょっと答えきれなかった部分も、これをきっかけに深めていけたらなと思ってます」。問われた側が、問いに感謝していました。
コラム 3 AIは、何を目指して訓練されているのか
AIの訓練で目指しているものは、3つです。順番に足していきます。① 見たものをなぞる(材料はインターネットの文章。次の1語を当てる練習)/② 人が好む方へ寄せる(材料は、AとBの2つを人に見せて、良いと思ったほうを選んでもらった記録。選ばれた方に高い点が付くようにする練習)/③ 機械で正誤が付くものを当てる(材料は数学とコード。正解と合っているかを機械が採点する練習)。
①でよく誤解されることがあります。AIは「よく見る語を好め」と教わってはいません。珍しい語にも正しい確率を付けるように鍛えられます。出てくる文が無難になるのは、この練習のせいではありません。聞き方の条件が薄いと、確率がよく見る言い回しに集まり、しかも出すときに高い山を選びやすくしているからです(→ コラム4)。

この3つに、「これは価値ある新しさか」を測る物差しはありません。①には「見た通りか」、②には「人が良いと思ったか」、③には「正解と合っているか」があります。新しさを測るものだけが、どこにもないのです。
ここで、②があるじゃないか、と思うはずです。「どちらが良いか」は機械では採点できないのに、人に選ばせて報酬にした。同じように「どちらがより新しいか」を選ばせればいい。理屈としては、できます。できるのに効かない理由は、別のところにあります。
本物の新しさは、出てきた時点では、少数の人にしか価値が分かりません。多数決で点を付けると、いちばん低い点が付きます。①は平均をなぞり、②は多数決に寄せる。2つとも、同じ方向へ働きます。
残るのは③ですが、③が使えるのは正解表が書ける場所だけです。「2 + 3 = 5」には機械が正誤を付けられますが、「この問いは面白いか」には付けられません。何を創るに値するかは、後者です。だから③にも載りません。欠陥ではありません。構造です。
AIが人間を超えた例を並べると、同じものが見えます。採点表を作ったのは、どれも人でした。
| 採点表を作ったのは | |
|---|---|
| AlphaFold | 人(予測した形を、実験で分かった形と比べる) |
| AlphaTensor | 人(掛け算の回数を数える。少ないほど良い) |
| AlphaZero | 人(将棋のルールと、勝ち負けの決め方) |
AIがやったのは、その採点表の中で点を上げることでした。AlphaZeroは自分で何百万局も指して、自分で練習相手を作りました。自分で問題を作ったように見えます。それでも、ルールと勝ち負けの決め方は人が置いたままです。動かしていないのは、そこです。
人の仕事は、問題と採点の仕組みを、前もって作ったところまででした。
この2時間が置かれていたのは、その真逆の場所です。答えを検算できず、報酬がどこにも無く、選別は人間がその場で1個ずつやる。候補は蛇口を全開にすれば何千個も出ます。だから創造の正体は「無から生む」より 「膨大な候補から、稀な意味あるものを選び抜く」ことになります。
ただし「AIは創造できない」は言い過ぎです。正確には「価値ある新しさを、自分で狙って、自分で判定することができない」。狙いと判定を外から入れれば、本物の発見に届きます。AlphaFoldは、そうやって届いた例です。
4. AIの1回目は、正しいが自明だった
21時18分。進行役が、それまでの議論の記録をまとめてAIに渡しました。指示は20字です。

短いですが、雑ではありません。3つの異なる思考操作を、正しい順序で名指ししています。アナロジーは別の領域から構造を借りること。抽象化は借りたものから共通構造を抜くこと。洞察はその抽象から、まだ言われていない主張を出すこと。順序が逆だと機能しません。抽象化を先にやると、材料がないので一般論になります。
返ってきた回答は、まずこの日の議論の現在地を、要約しました。
次がアナロジーです。数学好きが別の分野へ渡った実在の橋を4つ並べました。それぞれに、成り立つ条件と崩れる条件が付いていました。
1. Project Euler── 数学の問題集サイト。ただし手計算では解けず、解くにはプログラムを書くしかない。数学の問いが入口の興味で、プログラミングは副作用として身につく。成立条件は、最初の一問が「既に持っている力」だけで着手できること。崩れる条件は、一問目から環境構築や言語を要求すること。
2. 競技プログラミング(AtCoder・情報オリンピック)── 数学オリンピック層が大量に流れ込んだ実在の水路。数学力が初日から通貨として通用し、初期レートに直結する。崩れる条件は、既有資産が入口で換金できない場。ここが急所です。
3. 将棋道場 ── 独学では強くなれなかった世界を、対局(即時のフィードバック)+棋譜(上位者の思考)+段位(梯子)で開いた。そして重要なのは、AIがトップ棋士を抜いた後も将棋が終わらなかったこと。藤井聡太世代はAIを検算器・研究相手として訓練に組み込み、強くなる速度がむしろ上がった。「AIに指させる」のではなく「AIで自分の読みを検証する」使い方が定着した。
4. ラジオ少年・マイコンBASIC少年 ── 雑誌のコードを写して動かし、改造したくなる。その勾配が、教科書が運べなかった層を工学へ運んだ。崩れる条件は、「動いた」の初回体験が遠いこと。当時は数分で音が鳴った。
AIは4つから共通構造を抜き出しました。抽象化です。
成功した橋は、すべて教材ではありません。共通するのは3条件です。
1. 既有資産の通貨化 ── 対象者が既に持つ力(数学・構造への興味)が、入口でそのまま最初の成功に換金される 2. 勾配の設計 ── 先へ進むほど新技能が自然に必要になる坂。知識が押すのではなく、問題が引く 3. 即時の検算器と梯子 ── 提出すると即座に採点され、段位が継続の原動力になる
一文にすると、人を新しい分野へ運んだのは教材ではなく、既有能力が入口で通貨として通用する問題の勾配でした。
そこから洞察が2本。1本目はKaggleの入口に、2本目は「民主化とは何か」に向いていました。
Kaggleの入口は、この対象者の既有資産を通貨として受け付けていません。いまのKaggleが入口で要求するのはPython・環境構築・作法であり、数学力と構造への興味は、最初のスコアに1円も換金されません。数学好きが最初に出会うのは「構造の面白さ」ではなく「作業」です。
これは今日の議論に出た矛盾 ──「教材は大量にあるのに、なぜとっかかりにくいのか」── への説明候補になります。足りないのは教材ではなく、既有資産を換金するレーンがないことです。
そして最後に、AIは自分の出力に成績を付けました。
山井さんが「提出できる人と理解して学べる人」を分けた問いに、AIは正面から答えを返していました。そして自分の弱いところまで申告しました。それでも、場の評価は厳しいものでした。
方向は当たっていました。足りなかったのは、形です。そしてAIは、正しいことを、通じない言葉で言っていました。
残り時間は30分でした。
5. 16分後、何が変わったか
止まりかけたその時、山井さんが方向を出しました。
進行役はこれをそのままAIへの指示に書き下ろしました。そして、最後に一句「類似サービスも検索してもらった上で、具体的な実現方法について考えてください。」を足しました。
21時34分。返ってきた回答の1行目は、正直な悪い知らせでした。
| 既存 | 何か | この案とどこが被るか |
|---|---|---|
| Kaggle Getting Started | 常設の入門コンペ・チュートリアルつき | 「初心者向けの易しいコンペ」自体は本家に既にある |
| Kaggle Playground Series | 毎月開催の軽量コンペ。シンプルな合成表データ、本番より取っつきやすい設計と公式が明言 | 「ボリューム・複雑さを落としたミニコンペ」はほぼこの形で実在 |
| Kaggle Community Competitions | 誰でも無料でコンペを開催できる。自動採点・順位表・ノートブック完備 | 「出題プラットフォーム」の器は既製 |
| SIGNATE練習問題・atmaCup初心者歓迎回 | 日本語・初心者向け講座つき | 日本語×初心者の場も既にある |
正直な判定: 「Kaggleを小さく・易しくして出題する」をそのまま作ると、Playground Seriesとほぼ正面衝突します。既存は全て「小さくした一気通貫」── データを軽く、タスクを簡単にしたフル工程だからです。
「類似サービスも検索してもらった上で」という一句がなければ、AIは「ミニマムなコンペ」を提案して終わっていました。そして2番目に、生き残る差分が書かれていました。
さきほどの将棋のアナロジーがここで効きます。将棋には「対局」の他に詰将棋・次の一手という、実戦を工程分解した競技形式があり、それが何百年も入口と訓練を担ってきました。
その場で調べた限り、Kaggleには「詰将棋」に当たるものがありません。常にフル対局(環境構築→前処理→モデル→提出)しか無く、易しいコンペも「短いフル対局」にすぎない。だから──
分解の軸を「データを小さく」ではなく「工程を切り出す」に変える。一問=一判断。
そして出題の型を3つ出しました。
1. 詰めKaggle ──「このノートブックは手元検証93%なのに提出すると71%。原因を特定せよ」。答えは一意で、自動採点できます。 2. 次の一手 ──「このベースラインに、スコアを上げる一手を1つだけ加えよ」。複数の正解があり、採点器が即判定します。 3. 構造クイズ ──「この検証の切り方はなぜ間違いか」。数学・論理の力がそのまま通貨になる問題です。
これが今夜の3条件(既有資産の通貨化・勾配・即時の検算器)を全て満たします。数学好きは環境構築ゼロで、1問目から論理力で解ける。続けるとコツが副作用で身につき、梯子の先が本番Kaggleに繋がる。そしてAIに丸投げしても「自分の判断力」が試される出題にできるため、山井さんの「提出できても理解して学べているか」への直接の回答になります。
変わったのは、大きく2つ
16分で起きたことを、指示の側から並べるとこうなります。
| 21:18 | 21:34 | |
|---|---|---|
| 長さ | 20字 | 151字 |
| 指定 | 思考の操作(アナロジー・抽象化・洞察) | 同じ + 方向 + 既知チェック |
| 方向 | なし | 工程を細分化してミニマムに(山井さんの発言) |
| 縛り | なし | 類似サービスも検索してもらった上で |
| 結果 | 正しいが自明。「筋のいい一覧」 | 主要な既存例と照合した上で、詰将棋の不在 |
操作を指定しても、方向がなければ自明で止まります。そして方向を出したのは、AIでも進行役でもありませんでした。
コラム 4 同じAIが、16分で変わった理由
21時18分の出力は自明で、21時34分の出力は場を動かしました。この16分で、AIは1バイトも変わっていません。変わったのは、直前に人間が足した条件です。
ここには機構的な理由があります。AIは「この文脈の次に、どの語がどの確率で来るか」を出す機械です。だから雑に聞くと、条件が薄いので、確率は世の中でいちばんよく見る言い回しに集まります。無難な答えが返るのは故障ではなく、設計どおりの正常動作です。
ここでよく混同されるものが2つあります。
- 温度(Temperature)を下げる ── 温度は、答えを出させるときの設定です。下げると確率のいちばん高い語ばかりを選び、上げると低い語も拾うようになります。ただし、同じ分布の中で選び方を変えているだけです。真ん中の凡庸へ向かう操作です
- 条件を足す ── 分布そのものを変形させて、山の位置を動かす操作です。それまで裾に埋もれていた場所に、新しい山が立ちます
21時34分に足された条件は2つでした。山井さんの「工程を細分化してミニマムに」という方向と、「類似サービスを調べた上で」という縛りです。
ただし、条件は「ありふれた答えから外す」ことはできても、どの低確率領域に価値があるかは決めません。そこは外から与えるしかありません。

持ち帰れることが1つあります。答えに満足できないときは、AIを責める前に、直前の自分の条件を疑ってください。
2時間の最後に、北村さんはこの手法についてこう言っています ──「みんなで話して、AIに食わせて、AIに考え出させて。それは平均値じゃなくて、条件下での回答を出させるみたいなアプローチというのが、面白いなと思いました」。
具体例がわからない、と言った
一手は出た。しかし、まだ形が見えません。
21時47分。AIは、フル対局と詰将棋の対比を図にしてから、それをKaggleに写しました。
【フル対局 ── 本番の将棋】
- 序盤も中盤も終盤も、全部やる
- 1局 = 数時間
- 覚えることが多すぎて、初心者は何が悪かったかすら分からない
↓ 初心者はここで挫折する
【詰将棋 ── 分解された一問】
- 盤面は途中から与えられる
- 「ここから3手で詰めよ」
- 1問 = 5分。答えが一意に決まる = 正解/不正解が即わかる
↓ 初心者はここから入り、終盤力という「一つの技能」だけが確実に鍛えられる
【フルKaggle ── 今の入口】
- 環境構築 → データ読込 → 前処理 → 特徴量 → モデル → 検証 → 提出
- 1コンペ = 数週間
- 数学力は、最初のスコアに1円も換金されない
【詰めKaggle ── 提案】
- 途中まで完成したノートブックが与えられる(盤面)
- 「この中の一手だけ考えよ」/1問 = 15分
- 論理力・数学力が、そのまま通貨になる
そして、一問の実物を出しました。
第7問「消えた22点」
状況 ── ある人が「顧客の解約予測」モデルを作った。手元の検証では 93点。ところが提出したら 71点 だった。
使ったデータは5列。顧客ID/年齢/利用月数/解約手続き日/解約したか。
問い:93点は嘘だった。なぜか。犯人の列を1つ選べ。
答えは「解約手続き日」。解約した人にしか存在しないデータ(未来の情報)が混ざっていました。予測に使うのはカンニングと同じで、本番では手に入らないから点が消えます。
詰将棋と同じ性質が3つあります。盤面(コード+データ)は与えられるので環境構築ゼロ。答えが一意なので機械が即採点できる。そして要るのはPython力ではなく「論理の目」です。
ここで、実践者の判定が下りました。
そこから彫り込みが続きます。
誰に届けるのかを問い直したのは数学アドバイザー。方向を出したのは高校3年生。それをAIへの条件に変換したのは進行役。詰将棋との連結を出したのはAI。それが本物かを判定したのは高校3年生。手数という彫り込みを足したのは起業家。データの制約を確かめたのは高校3年生。誰が欠けても、この一手には着きませんでした。

コラム 5 AIが出せる新しさと、出せない新しさ
「既にあるものの組み合わせ」であることは、価値がないという意味ではありません。理由は、組み合わせの数です。

だから新しさは、材料の側では決まりません。その連結を、まだ誰も見つけていなかったかどうかで決まります。
価値ある新ビジネスを創造した例として、よく知られているものから並べます。
  【タクシーの配車】       電話で呼んで、来るのを待つ
  【スマートフォンのGPS】   いま自分がどこにいるかが分かる
  【空いている時間と車】     使われないまま置かれている
              ↓
  3つをつないだものが Uber

  ※どれも2010年より前からあった。
    つないだ人がいなかったから、その仕組みが世に無かった
研究の世界にも、古くから知られている例があります。
  【魚油の研究】        血液の粘度を下げる
  【レイノー病の研究】   指先の血流が悪くなる病気
              ↓
  共通していたのは「血液の粘度」

  ※論文はどちらも先に存在していた。
    両方を読む人がいなかったから、誰もこの橋を渡らなかった
この日に起きたことも、同じ形でした。
  【将棋】     詰将棋という、分解された一問がある
  【Kaggle】   分解された一問が、無い
              ↓
  共通していたのは「実戦を工程分解した競技」という形

  ※どちらも誰でも知っている。
    並べて見る人がいなかったから、誰も気づいていなかった
ここで、AIが強い理由と、人が要る理由が分かれます。AIは、連結の候補を大量に出せます。人にできない量です。ところが、出てきた候補のどれに意味があるかは決められません。コラム3のとおり、それを測る物差しを持っていないからです。
AlphaFold と AlphaTensor が超人的になれたのは、賢いからというより、採点できたからでした。予測した形が実験と合うか、かけ算の回数が少ないかは、機械が判定できます。この2時間の問いは、そこが作れません。だから候補は出ても、選ぶのは人になります。
新しいものの作り方は、これだけではありません。もう1つあります。
  足す(連結)
    既にある要素を2つつなぐ
    例  将棋の詰将棋 × Kaggleの工程 = 詰めKaggle
    ※組み合わせの数が膨大だから、見つけていないものが必ず残る

  引く(前提を外す)
    「これは前提だ」と思われていたものを、選択肢に変える
    例  平行線公理を捨てる
    ※組み合わせでは作れない。足し算の外にある操作
ユークリッドは「直線外の1点を通る平行線は1本だけ」を公理に置きました。それから約2000年、誰もがそれを他の公理から証明できるはずだと考えていました。1830年ごろ、ロバチェフスキーとボヤイは証明するのをやめて、その公理を捨てました。すると、平行線が無限にある世界も、1本もない世界も、矛盾なく作れました。
そして、引いたものは、あとから足したものに見えます。非ユークリッド幾何は、いまでは「4つの公理と、曲がった面の性質の組み合わせ」と説明できます。発見の前は誰も要素として持っておらず、発見の後は誰でも組み合わせとして説明できる。内と外の線は、見る時点で入れ替わります。
この日にやったのは、点をつなぐ側でした。「これは前提だ」と思われていたものを外す側は、やっていません。
6. 答え合わせ
最後に、冒頭の丸投げ回答をもう一度見ます。
Kaggleの民主化、面白いテーマですね。Kaggleの現状の課題を整理すると、「参入障壁が高い(統計・ML知識、英語、GPU環境)」「上位勢と初心者の断絶」「実務との乖離」あたりがボトルネックです。それぞれを崩すサービスアイデアをいくつかご提案します。
1. 「Kaggle Sherpa」— AIメンター伴走型コンペプラットフォーム
2. 「Micro-Kaggle」— 1時間で完結するマイクロコンペ
3. 「Kaggle for Domain Experts」— コード不要のコンペ参加
4. 「実データKaggle」— 中小企業の課題をコンペ化
5. 「Kaggle Replay」— 過去コンペのタイムマシン学習
あの5案は悪くありませんでした。2番と5番は、生まれた案の隣接領域にすらいます。丸投げでも「筋のいい方向の一覧」は出るのです。
しかし決定的な違いが2つあります。
第一に、5案はすべて「コンペに人を近づける・小さく易しく伴走つきにする」という枠の内側にいました。競技の単位そのものを作り変える枠には、一度も足を踏み入れていません。
第二に。丸投げ回答の末尾で、AIはこう書いていました。
一番事業性が高いと考えるのは 4(実データKaggle)+ 3(ドメイン専門家の取り込み)の組み合わせです。理由は3つです。
- 「民主化」の対象を、参加者側だけでなく出題側にも広げている点が独自
- 合成データ生成技術(プライバシー保護)が成熟してきた今だからこそ成立する
- 収益源が明確(企業からのSaaS課金)で、賞金依存のKaggleモデルより持続可能
AIが「独自だ」と言った根拠は、参加者側ではなく出題側に広げることでした。
思い出してください。その方向は、この2時間のうちに、すでに成り立たなくなっていました。進行役が出した「高校生が出題側になる」案を、山井さんが「データの量と質」で数分のうちにだめだと判断し、「興味は実課題ではなく構造に向かう」と反転させた、あの場面です。
AIが自分で「一番いい」と言った案は、この2時間のうちに、実践者の判断ですでに捨てられていました。AIは候補を出せる。しかし、どれが本物かを選ぶ物差しを持っていない──コラム5に書いたこの構造が、2時間の実地で実演されました。
7. できたもの
生まれた案は、そのままでは形になりませんでした。完成までの1ヶ月の経緯は、開発の記録にあります(近日公開予定)。
プロダクトの特徴
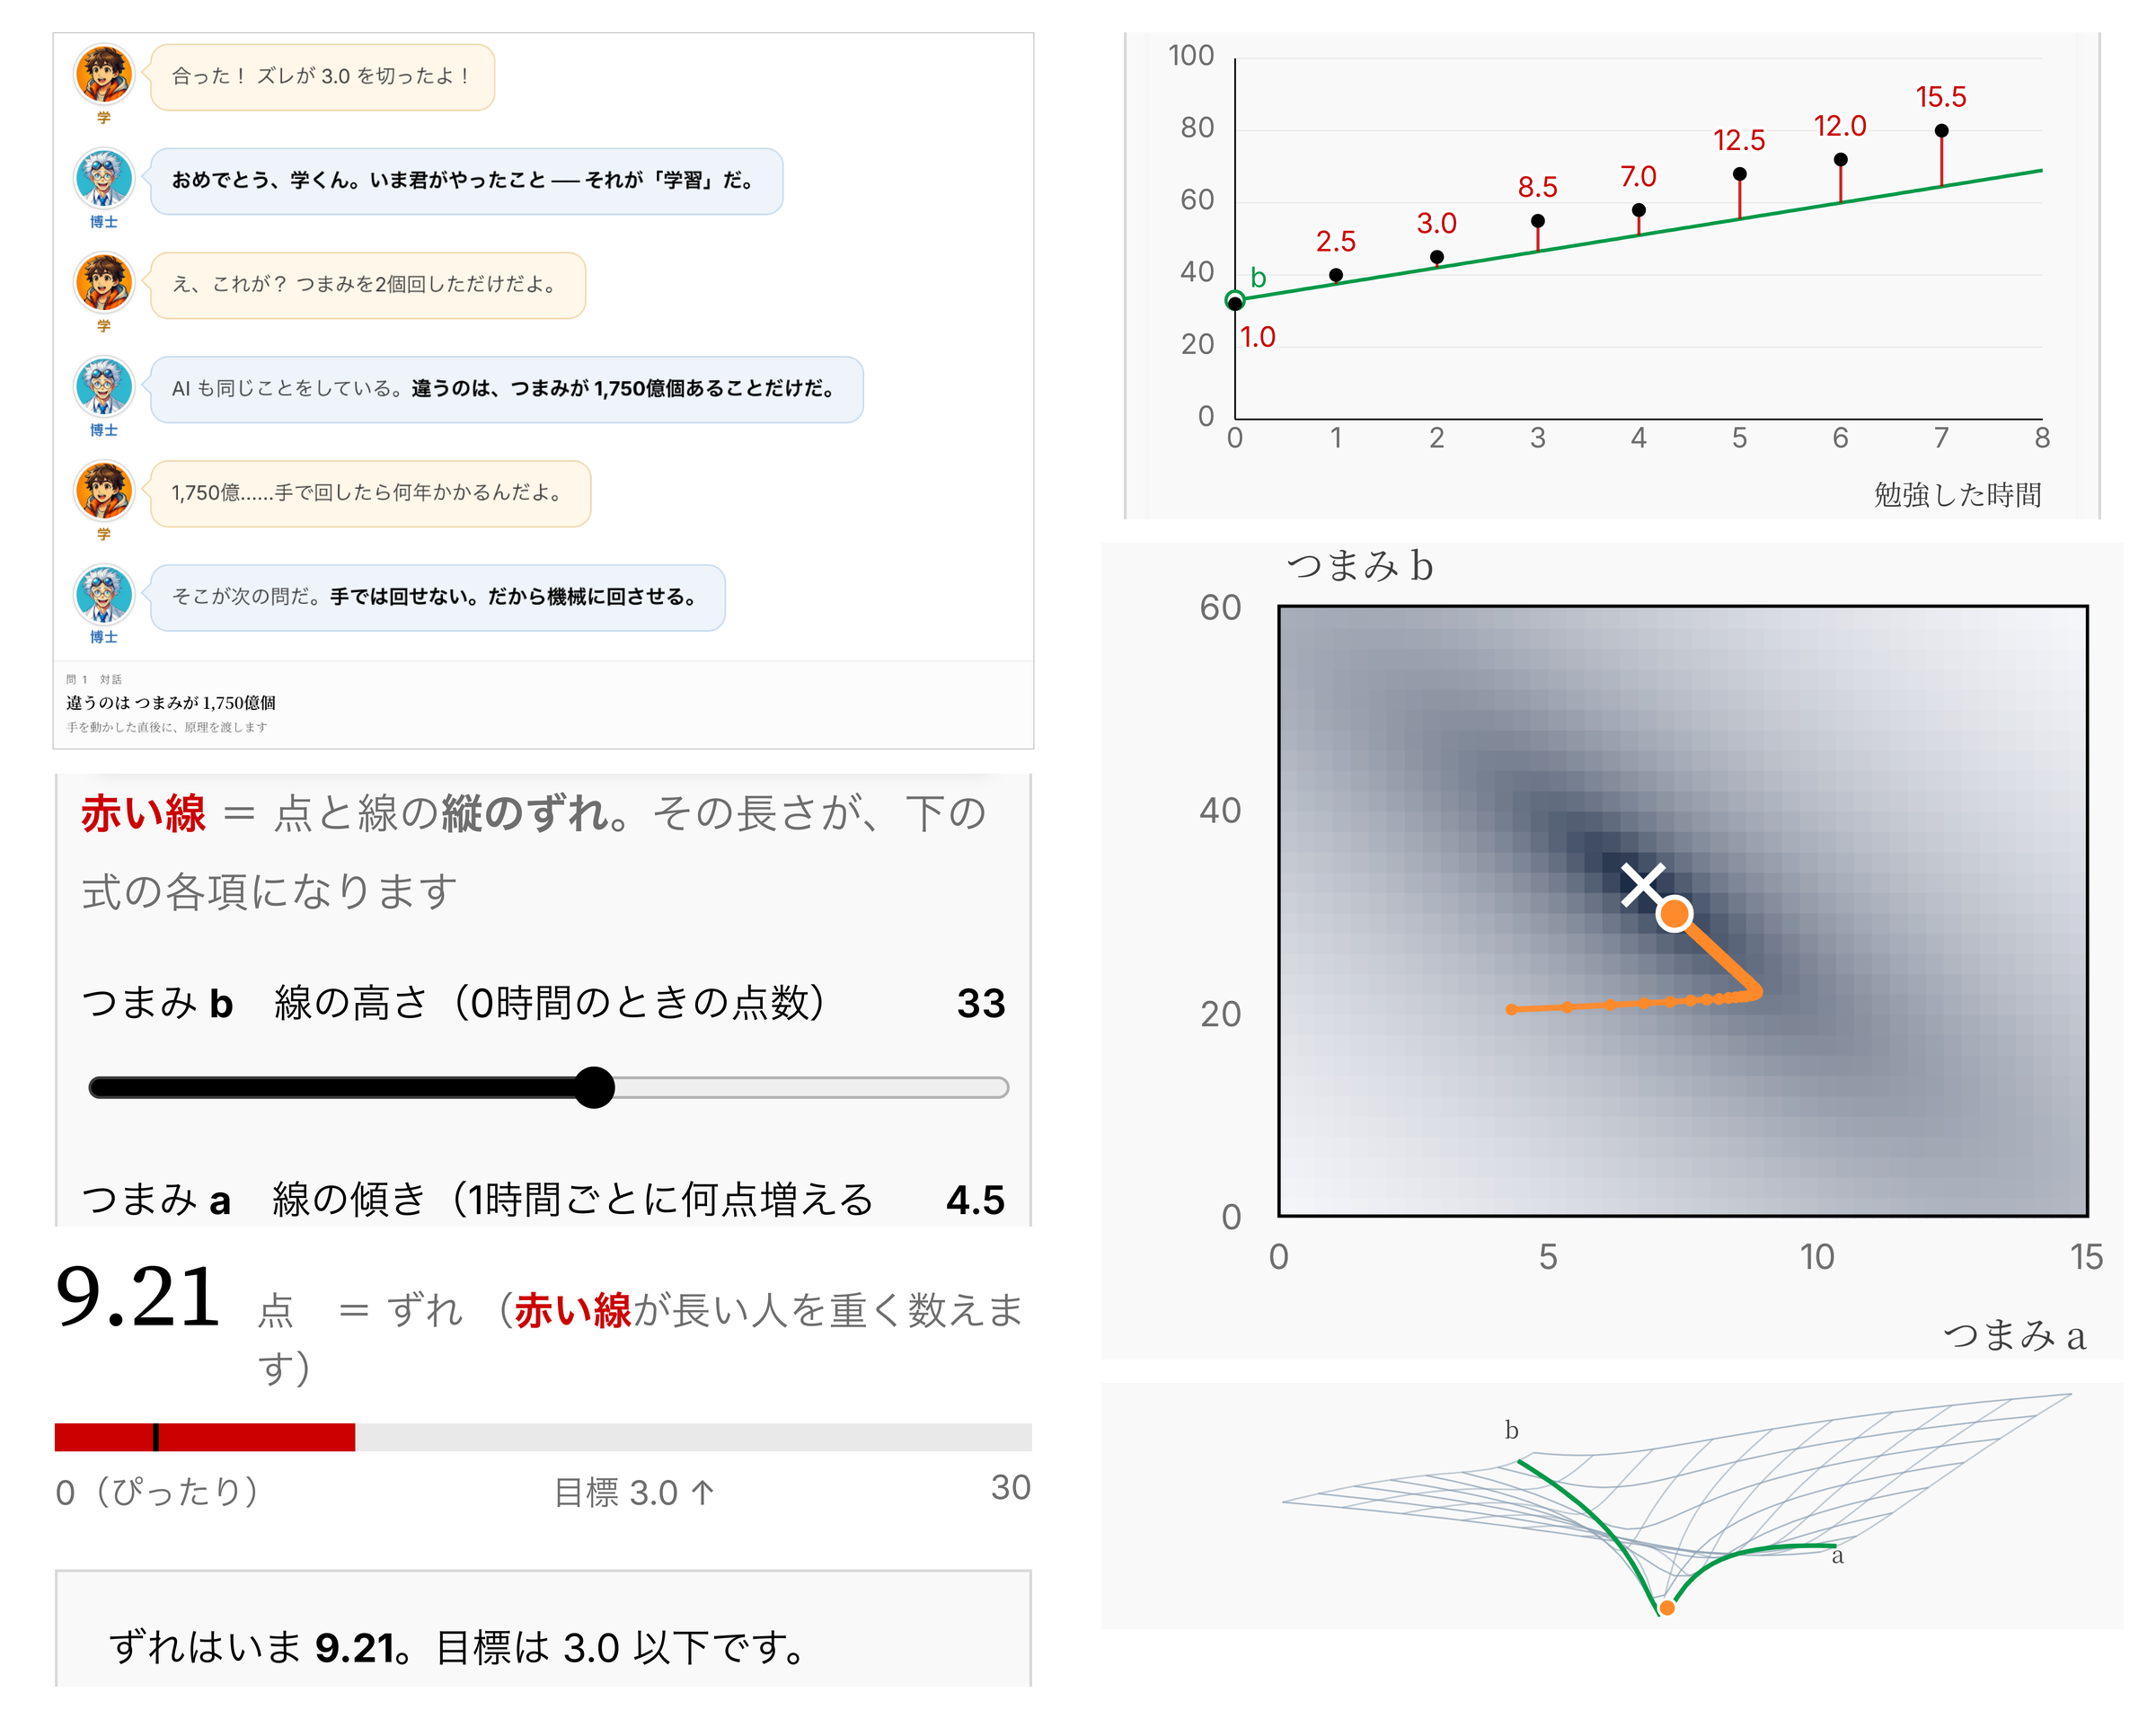
1. 対話で読みながら、そのまま自分で動かせます
博士と高校2年生のやり取りで進みます。説明を読むのではなく、会話を追っていくと分かる形にしました。
対話形式でわかりやすいAIの入門書も、触って動かせるAIの可視化ツールも、一問ずつ出題して採点してくれる演習サイトも、すでに世の中にあります。ただし、3つを兼ねたものは見つかりませんでした。だから作りました。
| 対話形式で読める | 自分で動かせる | 出題され、判定される | |
|---|---|---|---|
| 対話形式の入門書(数学ガールの秘密ノート など) | ○ | ✗ | ✗ |
| AIの可視化ツール(Transformer Explainer など) | ✗ | ○ | ✗ |
| 一問形式・自動採点の演習サイト(Deep-ML など) | ✗ | ○ | ○ |
| Deep Black Box | ○ | ○ | ○ |
2. 全21問、自分で手を動かします
読むだけの問題は1つもありません。多くの問題にはつまみ(左右に動かすスライダー)が並んでいて、動かしているのはAIの中身の数値そのもの、つまりパラメータです。つまみのない問題は、ボタンで切り替えたり、3択で先に予想したりする形になります。
3. 画面の数字は、すべて実測値です
AIは難しいので分かりやすく書く必要がありますが、分かりやすくしすぎると正確ではない表現になることがあります。だから機構は原論文32本に紐づけました。原論文から解き明かす生成AIという本で紹介されている原論文32本を参照しています。そして、このゲームのために簡単にした場所は「ここは簡単にしました」と書いてあります。
4. 準備がいりません
インストールも環境構築も不要。ブラウザで開くだけ。スマートフォンでもできます。
Deep Black Box
AIのブラックボックスを、1問ずつ開けて手で動かす。全21問。
この記事について
この記事は、Agora の第1回の記録です。少人数の選抜制で、第1期は招待とご紹介を中心に進めています。
Agoraを開催しているのは六本木ベンチャーキャピタルです。数学オリンピック・科学オリンピックのメダリスト級の中高大学生を対象に、選抜された参加者がAIを使ってプロダクトを作り、世に出すまでを体験するインキュベーションプログラムを運営しています。