Deep Black BoxAIのブラックボックスを、1問ずつ開けて手で動かす。全21問。
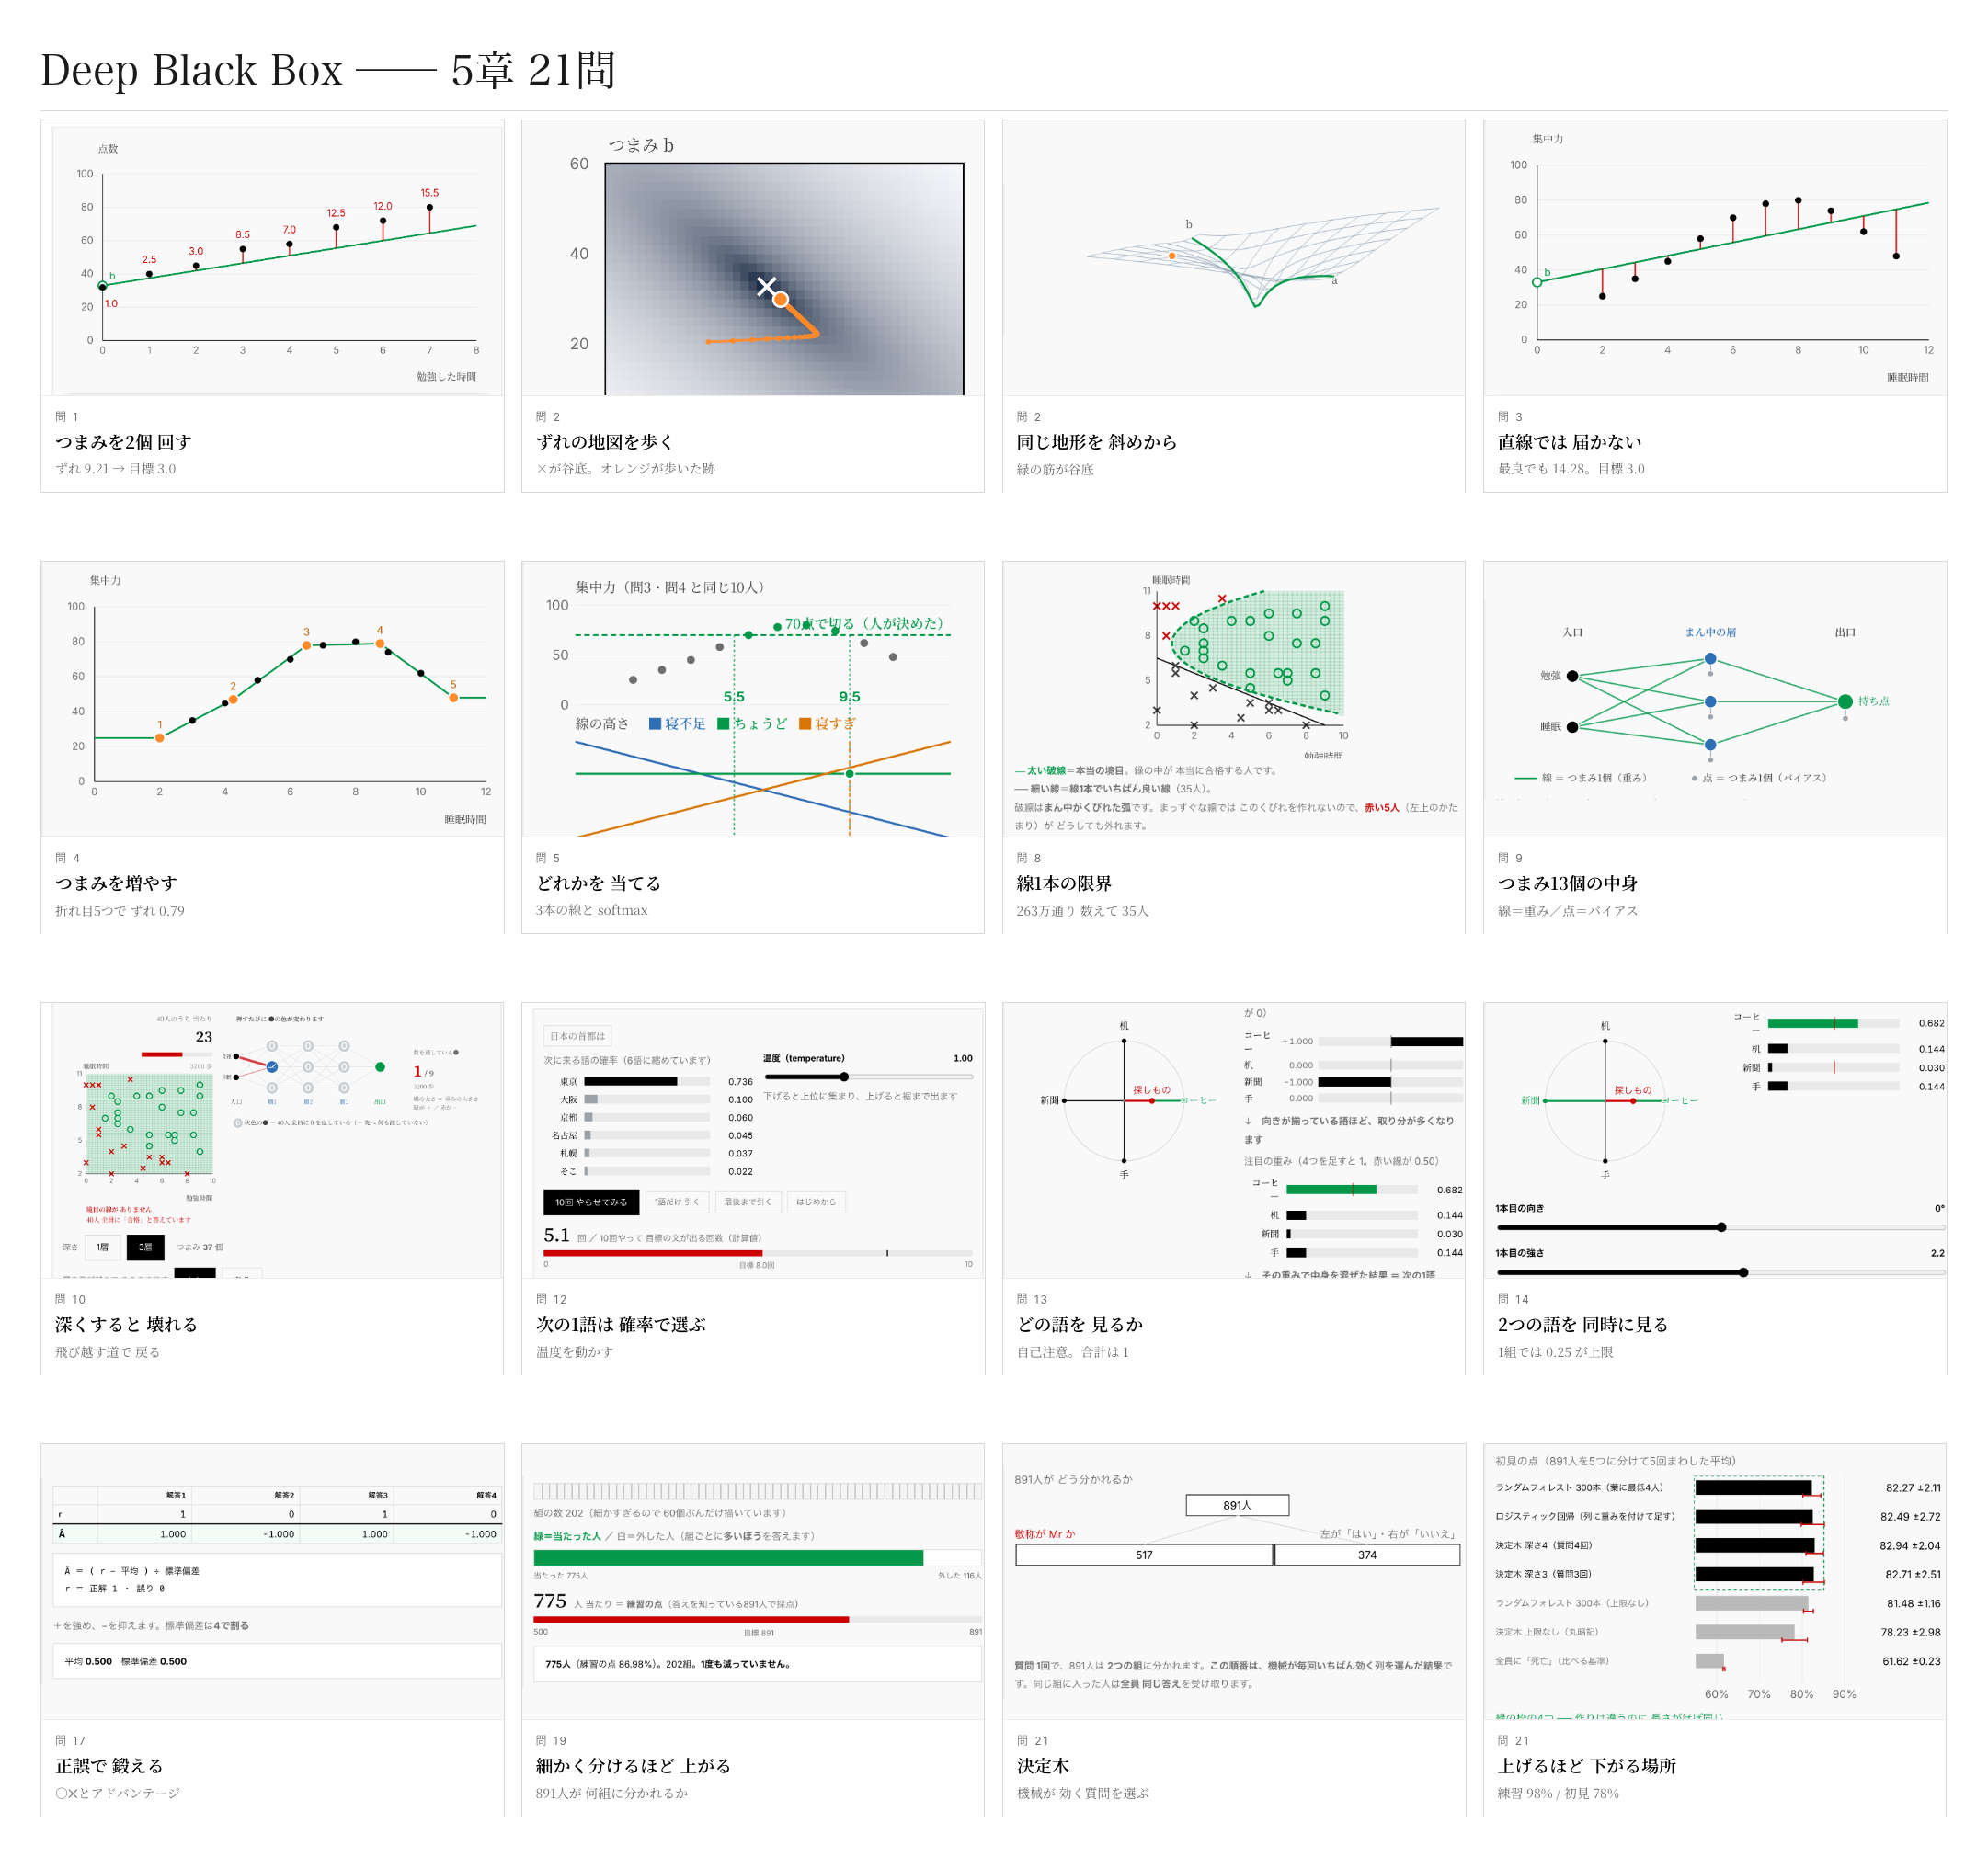
全21問を章ごとに並べた画面
図 1 21問のうち16問の画面。どの問題も、つまみ(パラメータ)や選択肢を動かすと数字とグラフがその場で変わり、目標に届いたかどうかが判定されます。直線1本から始まり、層を重ねたネットワーク、言葉を選ぶ確率、本物のデータへと進みます。

何が学べるか

章題中身
1機械学習 AIが学習するとは、具体的に何をしているのか。数を調整して正解に近づける、その一番小さい形を自分の手で動かします 1〜5
2深層学習 深層学習の「深い」とは、何が深いのか。層を重ねる意味と、重ねただけではうまくいかない理由を、自分で層を足しながら確かめます 6〜11
3LLM ChatGPTは中で何をしているのか。動いているLLMが次に来る語を確率で選ぶしくみと、同じ質問でも答えが変わる理由を、動かして見ます 12〜14
4LLMはどうやって作られるのか なぜAIは丁寧に答え、数学は得意で、それでいて自信を持って間違えるのか。次の語を当てる練習、人が選んだ記録で整える、正誤が付く問題で鍛える、という3段に分けて動かします 15〜17
5本物のデータでは、何が精度を決めるのか タイタニック号の乗客891人の記録から、年齢・性別・客室の等級をもとに生死を当てます。Kaggleで最もよく使われる入門課題です。使う道具は決定木です 18〜21

数式は出てきますが、自分で計算する必要はありません。つまみを動かすと、画面がその場で計算します。

中学生でも進められます。微分や対数を習っていれば、なぜそうなるかまで踏み込めます。

第1章 機械学習
  • 関数(入力から出力を計算する式)── y = ax + b から始めます。a と b がパラメータ(つまみ)です
  • 誤差(正解とのずれ)── 予測と正解の差を1つの数にまとめたもの。これを小さくするのが目標です
  • 勾配降下法(坂を下る)── 坂の高さは誤差です。傾きを調べて、誤差が減る方向へパラメータを少しずつ動かします。機械が自分でパラメータを決めるのは、この繰り返しです
  • 学習率(歩幅)── 大きすぎると坂を通り過ぎ、誤差が増え続けて戻れなくなります
  • 式の形の限界 ── 直線の式では、どうパラメータを動かしても届かない問題があります。パラメータを増やして折れ線にすると届きます
  • softmax(点数を確率に直す)── 点数のまま足し引きすると差が縮んでしまうので、指数を使って合計が1になる確率に直します。大小の順は変わりません
第2章 深層学習
  • 特徴量(入力に使う列)── 1個から複数に増やします。関係のない列を足しても誤差は下がりません
  • 正規化(単位をそろえる)── 身長cmと体重kgのように桁が違う列を混ぜると、片方だけが効きすぎます。歩幅は全パラメータで共通なので、揃えないと学習が壊れます
  • 直線の限界 ── 1本の直線では分けられない配置があります
  • 中間層(あいだの段)── 段を挟んでパラメータを増やします
  • 活性化関数(折り曲げる)── 折らないと、何段重ねても全体は直線1本と同じになります。だから段のあいだで曲げます
  • 勾配消失(深くすると壊れる)── 段を増やすと、誤差の手がかりが手前の段まで届かなくなり、手前の段が学習しなくなります。飛び越す道(残差接続)で直します
  • 過学習 ── 訓練データだけに合わせすぎた状態です(第5章で実際に体験します)
第3章 LLM
  • 語彙(出口)── 出力側の選択肢のことです。「次に来る語」の候補が5万個あり、それぞれに確率が付きます
  • 確率分布 ── 5万個の確率の並び。いちばん高いものを選び続けると、無難な言い回しになります
  • 温度 ── その並びの中から、どれだけ確率の高いものに寄せるかの設定です。上げると低い確率の語も出てきます。ただし並び自体は変わらないので、並びを変えたいときは質問に条件を足します
  • 自己注意(注目)── 文中のどの語を手がかりにするかの重みです。重みの合計が1になるので、複数の語を同時に強く見ることには上限があります
  • マルチヘッド ── だから重みを複数本に分けて、別々の語を見られるようにします
第4章 LLMはどうやって作られるのか
  • 事前学習 ── 大量の文章で「次の語を当てる」練習だけをします。文法や事実は、この練習の副産物として付いてきます
  • RLHF(人の好みで整える)── 「良い回答」は式に書けません。だから人に2つ見せて良いほうを選んでもらい、その記録を使って調整します。誰に選んでもらったかで結果が変わります
  • RLVR(正誤で鍛える)── 答え合わせが機械でできる問題(数学・プログラム)だけを使って鍛えます。だから数学は伸び、面白さのような正解のないものはこの段では扱えません
  • 自信を持って間違える理由 ── 訓練で選んでいるのは正しいことではなく、次に来そうなことだからです
第5章 本物のデータでは、何が精度を決めるのか
  • データ ── タイタニック号(1912年に沈んだ客船)の乗客891人の記録。年齢・性別・客室の等級などから、生き残ったかを当てます。Kaggleで最もよく使われる入門課題です
  • 特徴量エンジニアリング(入力の列を作る)── 人が新しい列を作ると、当たる数が増えます。たとえば名前から敬称を取り出します
  • 訓練の点は物差しにならない ── 列を増やすと訓練データの点は上がりますが、それは実力ではなく、極端には丸暗記です
  • 決定木 ── 勾配降下とは別の仕組みです。切れ目を全部試して、いちばん良いものを選びます
  • 交差検証 ── 1回だけ測ると数字がぶれます。分けて何回か測り、平均を取ります
  • 作りの違うモデルを並べると、同じ水準に並びます。モデルより入力が効く場面がある、ということです

プロダクトの特徴

1
対話で読みながら、そのまま自分で動かせます

博士と高校2年生のやり取りで進みます。 説明を読むのではなく、会話を追っていくと分かる形にしました。

対話形式でわかりやすいAIの入門書も、触って動かせるAIの可視化ツールも、 一問ずつ出題して採点してくれる演習サイトも、すでに世の中にあります。

ただし、3つを兼ねたものは見つかりませんでした。だから作りました。

対話形式で読める自分で動かせる出題され、判定される
対話形式の入門書(数学ガールの秘密ノート など)××
AIの可視化ツール(Transformer Explainer など)××
一問形式・自動採点の演習サイト(Deep-ML など)×
Deep Black Box
対話とつまみとグラフが同じ画面にある例
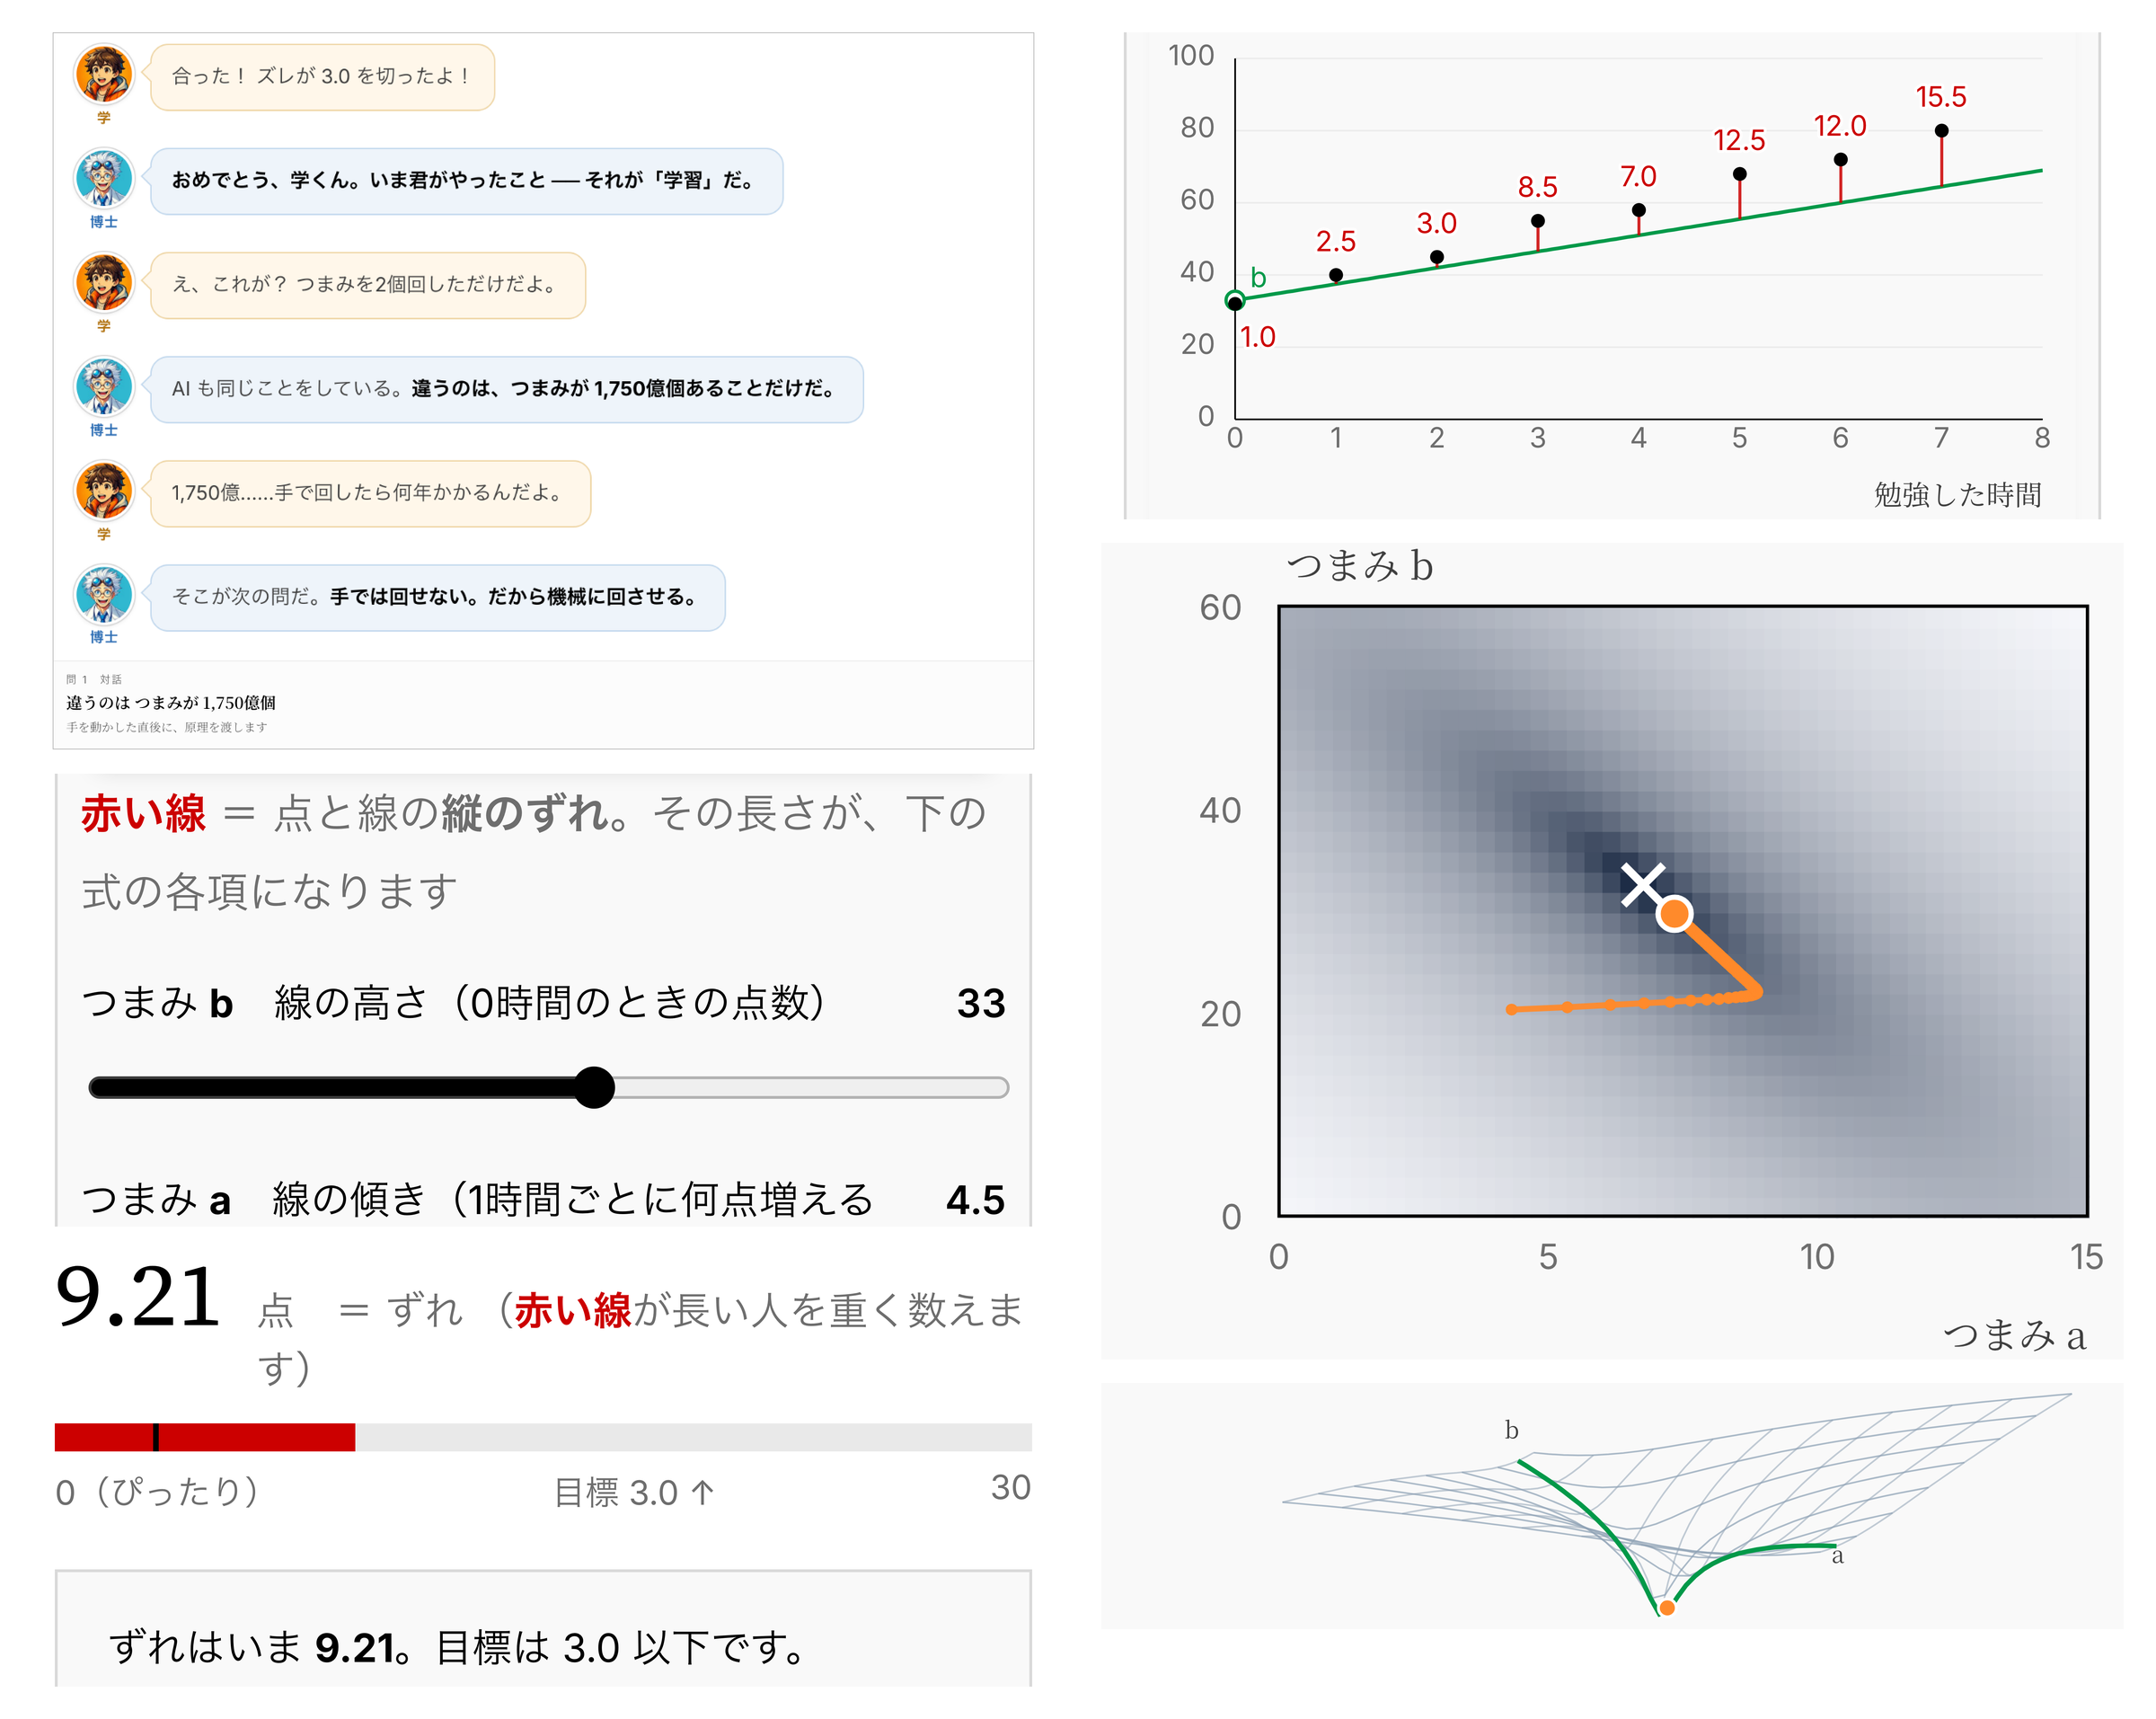
図 2 各問は博士と高校生のやりとりで始まり、そのあと自分で動かします。問1では、つまみを2つ動かすと線が点に近づき、ずれの点数がその場で返ります。問2では、そのずれを地形にして、いちばん低い場所へ向かって下ります。
2
全21問、自分で手を動かします

読むだけの問題は1つもありません。多くの問題にはつまみ(左右に動かすスライダー)が並んでいて、動かしているのはAIの中身の数値そのもの、つまりパラメータです。つまみのない問題は、ボタンで切り替えたり、3択で先に予想したりする形になります。

3
画面の数字は、すべて実測値です

AIは難しいので分かりやすく書く必要がありますが、分かりやすくしすぎると正確ではない表現になることがあります。だから機構は原論文32本に紐づけました。原論文から解き明かす生成AIという本で紹介されている原論文32本を参照しています。そして、このゲームのために簡単にした場所は「ここは簡単にしました」と書いてあります。

4
準備がいりません

インストールも環境構築も不要。ブラウザで開くだけ。スマートフォンでもできます。

なぜ作ったか

AIをつくる人を増やすには、原理を学ぶ入口が要ります。

そう考えたのは、国際人工知能オリンピック(IOAI)2025 銅メダリスト・開成高校3年の山井勇人さんです。彼がこの世界を知ったのは高校1年の冬。偶然でした。それから1年たたずにメダルを取っています。足りていなかったのは能力ではなく、知る機会でした。

「AIをどう使うか」はよく語られます。けれど、中で何が起きているかは、あまり教わりません。

六本木ベンチャーキャピタルの「Agora」第1回で、5人とAIが2時間 議論しました。数学や構造の面白さに反応する高校生に、入口を1つ届けるために作ったものです。

Agoraは、突出した若い才能が、AIと深く議論して、まだ世にない新しいものを生み出すプログラムです。